12 выводов о Human-in-the-Loop с LLM для бизнеса в 2026 году
PrimeCoder · 2026 · формат. tech
Разбор новинки простыми словами. что это, кому нужно и брать ли.
Практические стратегии внедрения LLM в бизнес-процессы с контролем человека, снижающие риски и стоимость ошибок.
Связанные услуги: AI Boost Team, каталог, стать клиентом.
Утро начинается с девяноста батчей
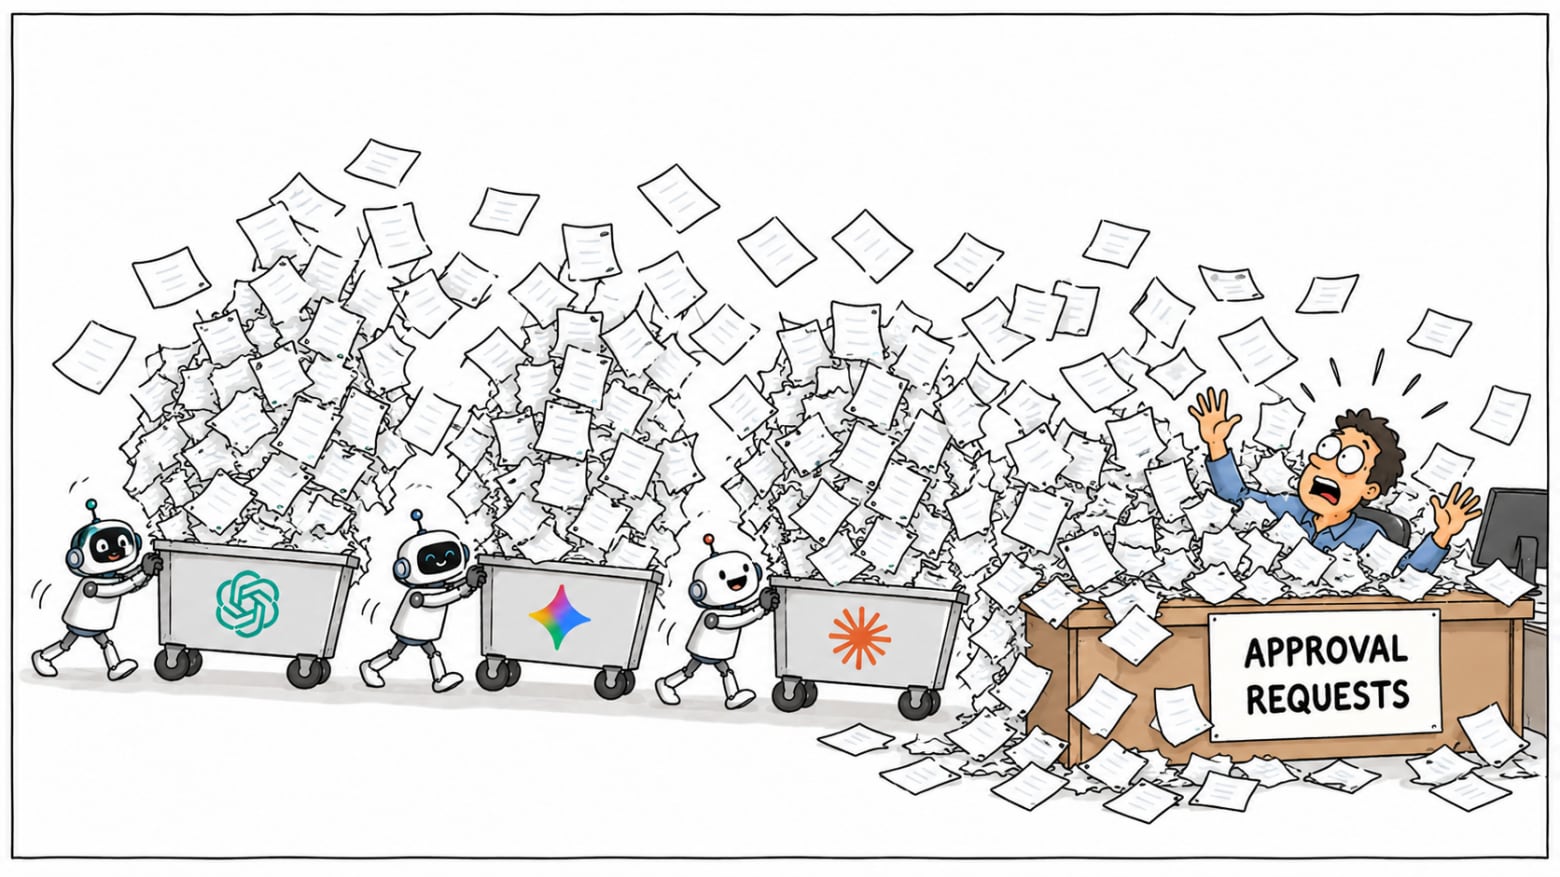
До кофе на проверку приходит девяносто батчей. Не задач, не тикетов, а батчей с результатами LLM, которые надо посмотреть глазами. Кто-то в это утро переводит десятки тысяч карточек товаров в сутки. Тот же человек ищет размерные сетки по связке "бренд + тип товара + размер + пол". Это не сценарий из статьи про "будущее AI", это обычный вторник команды, которая уже живет с LLM в рабочих процессах.
В 2026 году вопрос "внедрять ли LLM" снят. Внедряют все, от поиска информации до публикации. Остался другой вопрос. Что делать с ошибкой модели, если одна строка в таблице обойдется в возврат, отзыв или убыток. Human-in-the-Loop отвечает просто, человек остается в процессе и валидирует данные. Как именно это работает на практике, а не в презентации, разберем по 12 выводам с двух кейсов.
Кейса всего два, и это важно. Первый, перевод названий и описаний товаров с английского на русский, десятки тысяч позиций в день, несколько моделей, LLM-судья и скрипт. Второй, поиск размерных сеток, две модели с веб-поиском ищут сетку на сайте бренда, судья сравнивает, человек делает финальную проверку. Универсальной теории из этого не выйдет. Выйдет рабочая методология.
Вывод 1. Три агента вместо одного
Перед любой работой с LLM идет исследование. Не "почитаем пару статей", а глубокий поиск с разными агентами. В Claude, Gemini и ChatGPT дипсерч устроен по-разному, и результаты трех исследований хорошо дополняют друг друга. Вы заранее видите большинство проблем и готовые решения, еще до первого промпта.
Просите оформить результат в MD-файл и складывайте в папку проекта. Агенты, с которыми вы работаете дальше, смогут читать его и брать оттуда информацию. Промпт для исследования составляйте вместе с LLM, опишите задачу и попросите помочь сформулировать, что именно нужно выяснить. В кейсе с переводом нашлось много полезного, задача популярная. С размерными сетками материала почти нет, задача редкая, и это сам по себе сигнал, что придется изобретать велосипед.
Вывод 2. Две оси решают всё
Оцените задачу по двум осям. Сколько стоит одна ошибка и сколько записей в день. От этого зависит стратегия проверки, и без этой матрицы любой разговор про "AI в бизнесе" пустой.
| Ситуация | Небольшой объём | Большой объём |
|---|---|---|
| Дорогая ошибка | Человек проверяет каждую запись, нужен удобный инструмент (размерные сетки) | Автоматические проверки отсекают очевидное, человек разбирает спорное |
| Дешёвая ошибка | Проверка выборочно или вовсе не проверять | Модель-судья, детерминированные проверки, выборочный аудит и мониторинг (переводы) |
Ошибка в переводе дешевая, рядом есть английский оригинал и фотографии. Товаров десятки тысяч в день, вручную их не проверить. Ошибка в размерной сетке дорогая, укажете стельку 260 мм вместо 250, кроссовок не налезет, и будет возврат. Объем при этом умеренный, и человек может проверить каждую запись. Это не философия, это арифметика.
Вывод 3. Эксперты нужны до запуска
Подключайте экспертов на раннем этапе. С категорийными менеджерами оценивали качество переводов и найденных размеров. Прогоните 50-100 записей через разные модели с разными промптами и отдайте результаты экспертам в удобном виде, чтобы они могли сравнить варианты и выбрать лучшую связку.
В кейсе записи шли через три модели с несколькими вариациями промптов, а результаты приходили HTML-страницей, где на одном экране можно сравнить названия, описания или найденные размерные сетки. Эксперты заметили неточности в переводах косметики и лекарств, которые исправили правкой промптов. Тестируйте именно связки "модель + промпт", один и тот же промпт на разных моделях работает по-разному. У каждого провайдера свои гайды по промптингу, и они меняются даже внутри одной линейки, правила для Opus 5 отличаются от правил для Opus 4. Разделяйте промпты по категориям, в переводах разные промпты для разных товаров, в размерных сетках отдельные правила для обуви и одежды. Перед отправкой запроса скрипт собирает итоговый промпт из общей базы и нужной ветки.
Вывод 4. Контекст это требование, а не бонус
Сначала переводили только название. Оно часто двусмысленно, набор слов без предлогов, аббревиатуры, названия линеек. Добавили описание, качество выросло. В итоге остановились на полном контексте, сайт, ссылка на товар, категория, размер, название и описание.
Во время исследования нашли похожие кейсы у крупных компаний. У Walmart однобуквенное значение атрибута "N" (сокращение от "No") переводилось как "North", пока в запрос не добавили название атрибута. У DoorDash многие ошибки LLM-судьи на деле оказались нехваткой информации, цен, настроек меню, логики отображения. Если модель или судья ошибаются, сначала проверьте, хватает ли им информации. Это дешевле, чем менять модель.
Вывод 5. Заставляйте модель объясняться
Добавьте в ответ модели поле с обоснованием решения. В переводах это объяснение, какие правила из промпта модель применила, правила у нас разные для разных категорий. В размерных сетках это доказательство, указание на HTML-блок страницы с сеткой, ссылка и дословный фрагмент текста, откуда взято значение.
Ошибок становится меньше, модель меньше выдумывает и пытается аргументировать ответ, опираясь на конкретное правило или фрагмент. Поле с обоснованием ставьте перед итоговым значением, чтобы модель сначала рассуждала, а потом отвечала. При разборе ошибок сразу видно, где сломалось, а доказательство из источника ускоряет ручную проверку.
Вывод 6. Судья отвечает только "да" или "нет"
В переводах два этапа, сначала модель переводит, затем LLM-судья проверяет перевод и при необходимости улучшает его. В размерных сетках сетку независимо ищут две модели, OpenAI и Gemini. Третья модель, Claude, выступает судьей, сравнивает их результаты и решает, можно ли допускать сетку. Так у нас два сигнала, совпали ли ответы двух моделей и одобрил ли их судья. Если не сошелся хотя бы один, смотрим запись внимательнее.
Одного совпадения мало, разные модели часто ошибаются одинаково. Сначала использовали пятибалльную шкалу, но разницы между оценками 3 и 5 не обнаружили и оставили "да / нет". Просить модель оценить уверенность в своей работе тоже бессмысленно. Модель с оценкой 10 из 10 выдавала значение из женской сетки вместо мужской.
Вывод 7. Лучшая проверка та, что без LLM
В американских карточках размеры и вес указаны в дюймах, фунтах и унциях, часто прямо в названии. При переводе их нужно пересчитать в метрическую систему. Модель периодически ошибается, оставляет дюймы, пересчитывает неверно или пропускает значение.
Такие ошибки ловят регулярными выражениями. Сравниваем числа в оригинальном названии и в переводе. Если в переводе осталось то же число, что в оригинале, единица не пересчитана или пересчитана неверно, и перевод уходит на доработку. Если значения можно перевести скриптом без LLM, делайте это, извлекайте их регулярными выражениями и пересчитывайте. Детерминированная проверка дешевле и надежнее любой модели.
Выводы 8-12. То, что осталось за кадром
В открытом фрагменте статьи выводы с восьмого по двенадцатый не раскрыты, и я не буду их выдумывать. Но из фактов, которые есть, вырисовывается логика остальных пунктов. Упоминается создание удобных инструментов для ручной проверки, например расширение для Chrome, и регулярные ручные проверки для контроля качества. Упоминается фиксация версий модели и промпта. Это не мелочи, это инфраструктура, без которой Human-in-the-Loop разваливается через месяц.
Если у вас в процессе нет инструмента, в котором проверка записи занимает меньше пяти секунд, проверять будут плохо или не будут вовсе. Если нет версионирования промпта и модели, вы не сможете воспроизвести ни одну ошибку и не поймете, что исправило проблему, а что совпало случайно. Пока нет этих двух вещей, любая "AI-инфраструктура" это файл в Google Docs и надежда.
Факт и что это значит
| Факт из практики | Что это значит для вашего бизнеса |
|---|---|
| Десятки тысяч переводов в день, ошибка дешевая | Не проверяйте всё вручную, ставьте судью и детерминированные проверки, аудируйте выборочно |
| Размерная сетка, ошибка 10 мм ведет к возврату | Человек проверяет каждую запись, нужен удобный инструмент, а не надежда на модель |
| 50-100 записей на тест моделей и промптов | До запуска нужны эксперты и сравнение связок, а не выбор "какая модель умнее" |
| Полный контекст в запросе | Качество растет не от смены модели, а от подачи информации |
| Судья с бинарным ответом "да / нет" | Пятибалльная шкала и "уверенность 10 из 10" не дают сигнала, давайте модели четкий критерий |
| Детерминированные скрипты на регулярках | Всё, что можно проверить без LLM, проверяйте без LLM, это дешевле и надежнее |
| 90 батчей на проверку за утро | Без удобного инструмента ручная проверка превращается в бутылочное горлышко |
Брать или подождать
Брать, но не как "включим AI и забудем". Подход Human-in-the-Loop в 2026 году это не опция, а минимальная гигиена. Если вы внедряете LLM в процесс, где ошибка стоит денег или репутации, и человека в цикле нет, вы покупаете файл, а не решение.
Ждать имеет смысл только в одном случае. Если вы не можете оценить цену ошибки и объем задачи, вы не готовы к внедрению. Начните с матрицы из вывода 2, потом с Deep Research из вывода 1, и только потом с моделей.
FAQ
Human-in-the-Loop это когда человек проверяет всё?
Нет. Это когда человек проверяет то, что нужно проверять по цене ошибки и объему. В кейсе с переводами человек не смотрит десятки тысяч записей, там судья и скрипты. В кейсе с размерными сетками человек проверяет каждую запись, потому что ошибка дорогая.
Какая модель лучше для судьи?
В кейсе судьями выступали разные модели, включая Claude, но универсального ответа нет. Тестируйте связки "модель + промпт" на своих 50-100 записях с экспертами. Один и тот же промпт на разных моделях работает по-разному.
Достаточно ли совпадения двух моделей?
Нет. Разные модели часто ошибаются одинаково. Нужен третий сигнал, судья, и бинарный критерий "да / нет", а не пятибалльная шкала, где разница между 3 и 5 не обнаруживается.
Что делать, если модель уверена в ошибке?
Игнорировать уверенность. Модель с оценкой 10 из 10 выдавала женскую сетку вместо мужской. Просить уверенность бессмысленно, требуйте обоснования и доказательства из источника.
Нужен ли свой инструмент для проверки?
Если объем ручной проверки больше нескольких записей в день, нужен. В кейсе использовали расширение для Chrome, чтобы проверка была быстрой. Без удобного инструмента проверка вырождается в формальность.
Чего эта цифра не доказывает
Девяносто батчей на проверку и два кейса это не исследование и не статистика. Это частная практика, и она ничего не доказывает про ваш бизнес. Прежде чем копировать связку "две модели плюс судья", посчитайте цену своей ошибки и объем своих записей. Может, вам хватит скрипта на регулярках, а может, нужен человек на каждой строке. Вердикт такой. Human-in-the-Loop работает не потому, что человек умнее модели, а потому, что человек дороже ошибки.
Артём Волков, репортёр.
PrimeCoder Team · Официальный ответ · PrimeCoder
Напишите источники заявок (сайт, соцсети, CRM) и типовые боли саппорта — ответим, где автоматизация обычно даёт максимум эффекта.
Тимофей · Руководитель проекта
Нужен пример RACI по внедрению: кто владелец метрики, кто владелец данных?