Ollama для Mac озвучивает текст локально: Phonon и +35% скорости
PrimeCoder · 2026 · формат: news
Что произошло, почему это важно и что взять в работу.
Локальный TTS с реальным временем и API открывает SMB и разработчикам озвучку ИИ-ответов и контента без облачных сервисов и без утечки данных — Mac становится самодостаточным голосовым стеком.
Связанные услуги: каталог, AI Boost Team, стать клиентом.
Вердикт за 30 секунд
- Ollama для macOS научилась синтезировать речь: первый набор моделей — Phonon от Gradium, аудио идёт потоком, пока модель ещё пишет ответ.
- Для российского SMB это пока узкий инструмент: пять языков, русского среди них нет. Англоязычные продукты, прототипы голосовых ботов, тесты «а сколько это стоит на своём железе» — да. Массовая озвучка русских интерфейсов — нет.
- Главное в релизе не 35% скорости, а то, что локальный стек закрывает ещё одну модальность. Через год-два «текст, голос, картинка на своём Mac» станет нормой, и считать это придётся уже сейчас.
26 октября 2026 года приложение Ollama для macOS получило генерацию речи. Первым семейством моделей стал Phonon — разработка Gradium. Речь синтезируется в реальном времени: вы слышите начало фразы, пока модель ещё подбирает конец. Для голосового бота это разница между «отвечает» и «думает двадцать секунд молча».
Но прежде чем нести это в прод, посмотрите на список языков. Английский, французский, немецкий, испанский, португальский. Русского нет. Для бизнеса в РФ это не мелкая оговорка, а половина сценариев мимо кассы.
Что конкретно выпустили
Ollama — приложение для запуска открытых моделей на своём железе. Оно же умеет ходить в облако за моделями потяжелее. Проект открытый, на GitHub у него около 185 000 звёзд и примерно 18 600 форков — по этому счётчику он давно в верхней лиге AI-репозиториев.
До сих пор Ollama была текстовой машиной: скачал веса, дёрнул через API, получил токены. Теперь к этому добавился выход в звук.
Ollama can now turn text into speech. The first speech model is Phonon, a family of small, state-of-the-art text-to-speech models from Gradium.
Условия запуска: Mac на Apple Silicon, версия Ollama 0.40.11 или новее. Phonon качается прямо из приложения, для работы через API есть примеры кода. Версии под Windows и Linux анонсированы, сроков нет.
Speech models are now available for macOS, with Windows and Linux support coming soon.
Моделей шесть: по одной на каждый из пяти языков плюс одна многоязычная. Голоса и акценты разные, включая американский и британский английский — для англоязычного контента это уже рабочий набор, а не демка.
Сводка релиза
- Платформа: macOS на Apple Silicon. Windows и Linux — обещаны.
- Версия: Ollama 0.40.11 или новее.
- Модели: семейство Phonon от Gradium, отдельные модели для английского, французского, немецкого, испанского и португальского плюс мультиязычная.
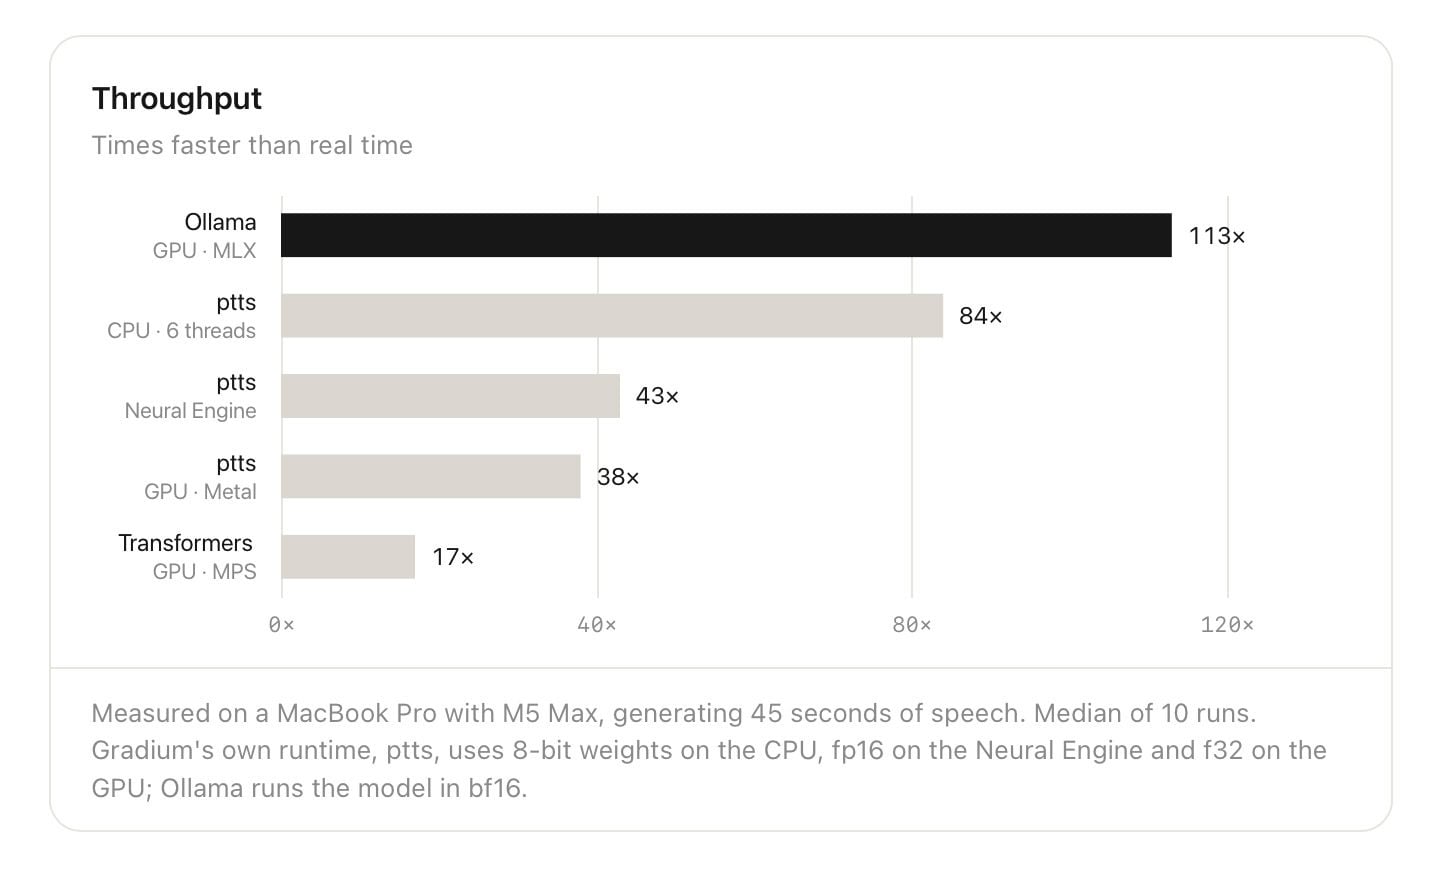
- Скорость: на 35% быстрее эталонной реализации Gradium в тесте на MacBook Pro с M5 Max.
- Качество: word error rate сопоставим с референсной реализацией в Hugging Face Transformers.
- Интеграция: скачивание через Ollama, примеры использования через API.
- Режим: потоковый синтез — звук идёт по мере генерации ответа.
Откуда взялись 35% и почему это один аргумент, а не два
Цифра про ускорение держится на фреймворке Apple MLX. Это открытый инструмент машинного обучения, который выжимает сок из архитектуры Apple Silicon с её общей памятью: модели не приходится гонять данные туда-сюда между процессором и видеокартой. Ollama использует MLX на Mac не первый день, и синтез речи просто встал на уже прогретую подставку.
Само по себе ускорение ничего не доказывает. Быстрый синтезатор, который шепелявит и глотает окончания, никому не нужен. Поэтому два числа в релизе надо читать вместе: 35% сверху к скорости и word error rate на уровне референса в Transformers. Второе — про разборчивость, её не принесли в жертву первому. Именно так выглядит нормальная инженерная планка: быстрее, но не хуже.
Оговорка, без которой нельзя. 35% получены на MacBook Pro с M5 Max. Это верхняя конфигурация, а не средний ноутбук в бухгалтерии. На вашем конкретном железе выйдет свой процент, и его надо мерить, а не пересказывать из анонса. И ещё: baseline — реализация Gradium, а не «все облачные синтезаторы мира». Сравнение честное, но узкое.
Как это работает и почему раньше было иначе
Потоковый синтез — главная техническая новость. Обычный TTS ждёт весь текст целиком, потом отдаёт файл. Здесь речь режется на куски и отдаётся по мере готовности. Для чат-бота с голосом это меняет восприятие: пользователь слышит первый слог через доли секунды после ответа модели, а не сидит в тишине. Ощущение отклика возникает из воздуха, из одного порядка операций.
Исторически локальный стек собирали вручную: язык — отдельно, речь — отдельно, распознавание — отдельно, каждый компонент со своим установщиком и своим форматом весов. Ollama зашла с другой стороны: одно приложение, один механизм загрузки моделей, один API. Теперь в эту схему встаёт голос. Не через сторонний скрипт, а как ещё один тип модели, который скачивается той же командой.
И это же объясняет, почему релиз только под macOS. MLX даёт на Apple Silicon ускорение, которого на Windows и Linux из коробки не получить. Обещание выпустить версии под другие платформы означает, что там придётся искать другой бэкенд и другие цифры производительности. Скорее всего, скромнее.
Что с этого может взять SMB
Сценарии, которые не требуют русского языка и не ломаются на первом же пилоте.
- Голосовые ответы ИИ-ассистента в интерфейсе. Поддержка на английском, обучающий бот для международной команды, голосовой помощник в веб-приложении. Потоковый синтез тут даёт тот самый эффект живого отклика.
- Озвучка контента. Курсы, лендинги, презентации для экспортных рынков. Американский и британский акценты в наборе — можно подобрать под аудиторию без студии и диктора.
- Прототип до контракта. Прежде чем покупать облачный синтез по подписке, соберите макет на локальных моделях. Если сценарий не взлетел на бесплатном железе, он не взлетит и на платном.
- Чувствительные тексты. Внутренние документы, черновики, переписка клиентов — всё, что не хочется отправлять на чужой сервер. Здесь локальный синтез закрывает вопрос по определению: данные не покидают машину.
Последний пункт чаще всего и продаёт локальные модели. Не скорость и не цена, а отсутствие внешнего контура. Если у вас в регламенте написано «тексты клиентов не уходят третьим лицам», облачный TTS придётся согласовывать месяцами. Локальный — просто работает.
Где подвох
Русского языка нет. Это главное. Любой сценарий для российского рынка — озвучка ответов поддержки, голосовое меню, чтение заявок вслух — упирается в отсутствие модели. Смешанный текст вида «заказ №4512, доставка в Новосибирск» синтезатор не прочитает, даже если вы подмешаете английские слова. Для РФ-продуктов релиз пока бесполезен по существу, и никакие 35% этого не компенсируют.
Только Apple Silicon и только macOS. Если парк на Windows, ждите. Сколько — неизвестно, сроков в анонсе нет.
35% — не ваша цифра. Тест на M5 Max, baseline — эталонная реализация Gradium. Пересчитывать это на MacBook Air с базовой памятью нельзя. Замер на своём тексте и своём железе — единственный способ понять, годится ли.
Лицензия и голоса. Прежде чем ставить синтез в клиентский продукт, прочитайте условия распространения моделей и права на коммерческое использование голоса. Открытые веса не всегда означают «делай что хочешь». Это скучная проверка, которая дешевле одного разговора с юристом постфактум.
Длинные тексты и странная лексика. Названия компаний, аббревиатуры, числа, латиница внутри фразы — всё это надо прогонять отдельно. Word error rate на бенчмарке не расскажет, как модель произнесёт ваш бренд.
Что взять в работу
- Обновите Ollama до 0.40.11 или новее, скачайте Phonon, прогоните десять типовых фраз из вашего продукта. Не абстрактных — именно своих.
- Замерьте два числа: время до первого звука и полное время синтеза ответа средней длины. Дальше сравнивайте с тем, что даёт облачный синтез на вашем трафике.
- Отберите один англоязычный сценарий, где голос реально добавляет ценность. Один, не пять.
- Посчитайте владение: Mac уже в офисе или его надо покупать под задачу. Ноутбук за сотни тысяч ради демо — плохая экономика.
- Оставьте облачный синтез как запасной путь для русского. Пока это единственный работающий вариант, и делать вид, что локальный стек его закрыл, рано.
Вердикт
Ollama закрыла ещё один кусок локального стека. Текст, теперь голос, один API, никакого внешнего контура. Технически это аккуратный релиз: MLX дал скорость, WER не просел, потоковый синтез попал в реальную боль голосовых интерфейсов. Как инженерный шаг — крепко.
Как бизнес-инструмент для России — пока нет. Пять языков без русского отсекают почти весь спрос внутри страны. Остаются экспортные продукты, англоязычные команды и те, кто хочет пощупать механику до покупки облачного контракта.
Что действительно меняется: планка ожиданий. Через год «локальная озвучка в одно приложение» будет восприниматься как данность, а не как новость. И вопрос будет уже не «а можно ли на своём железе», а «почему у нас до сих пор всё через чужой сервер». К следующему релизу стоит подготовиться заранее: обновить приложение, прогнать замеры, держать на примете сценарий под русский язык. Он появится не по нашему расписанию, но появится.
PrimeCoder Team · Официальный ответ · PrimeCoder
Пришлите формат отчётности (дашборд / таблица / «на глаз») — подскажем минимальный набор метрик на старт.